Cos’è il RAG
Un modello linguistico, come quelli dietro ChatGPT, Claude o Gemini, ha imparato moltissimo leggendo testi pubblici fino a una certa data. Ma non conosce i vostri documenti: listini, manuali tecnici, procedure interne, contratti, storico dei ticket. Se gli fate una domanda su questi, ha due possibilità: dire che non lo sa, oppure inventare una risposta plausibile. È la cosiddetta allucinazione.
Il RAG risolve il problema senza toccare il modello. Invece di sperare che sappia la risposta, gliela si mette davanti: un sistema di ricerca trova nei vostri documenti i passaggi pertinenti alla domanda, li inserisce nel prompt, e il modello risponde leggendoli. Come uno studente all’esame a libro aperto, con l’indice già consultato da qualcun altro.
Il termine viene da un articolo del 2020 di Patrick Lewis e altri ricercatori di Facebook AI Research, University College London e New York University, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, presentato a NeurIPS 2020. Da allora è diventato il modo standard per collegare un’AI generativa alla conoscenza di un’azienda.
Come funziona, passo per passo
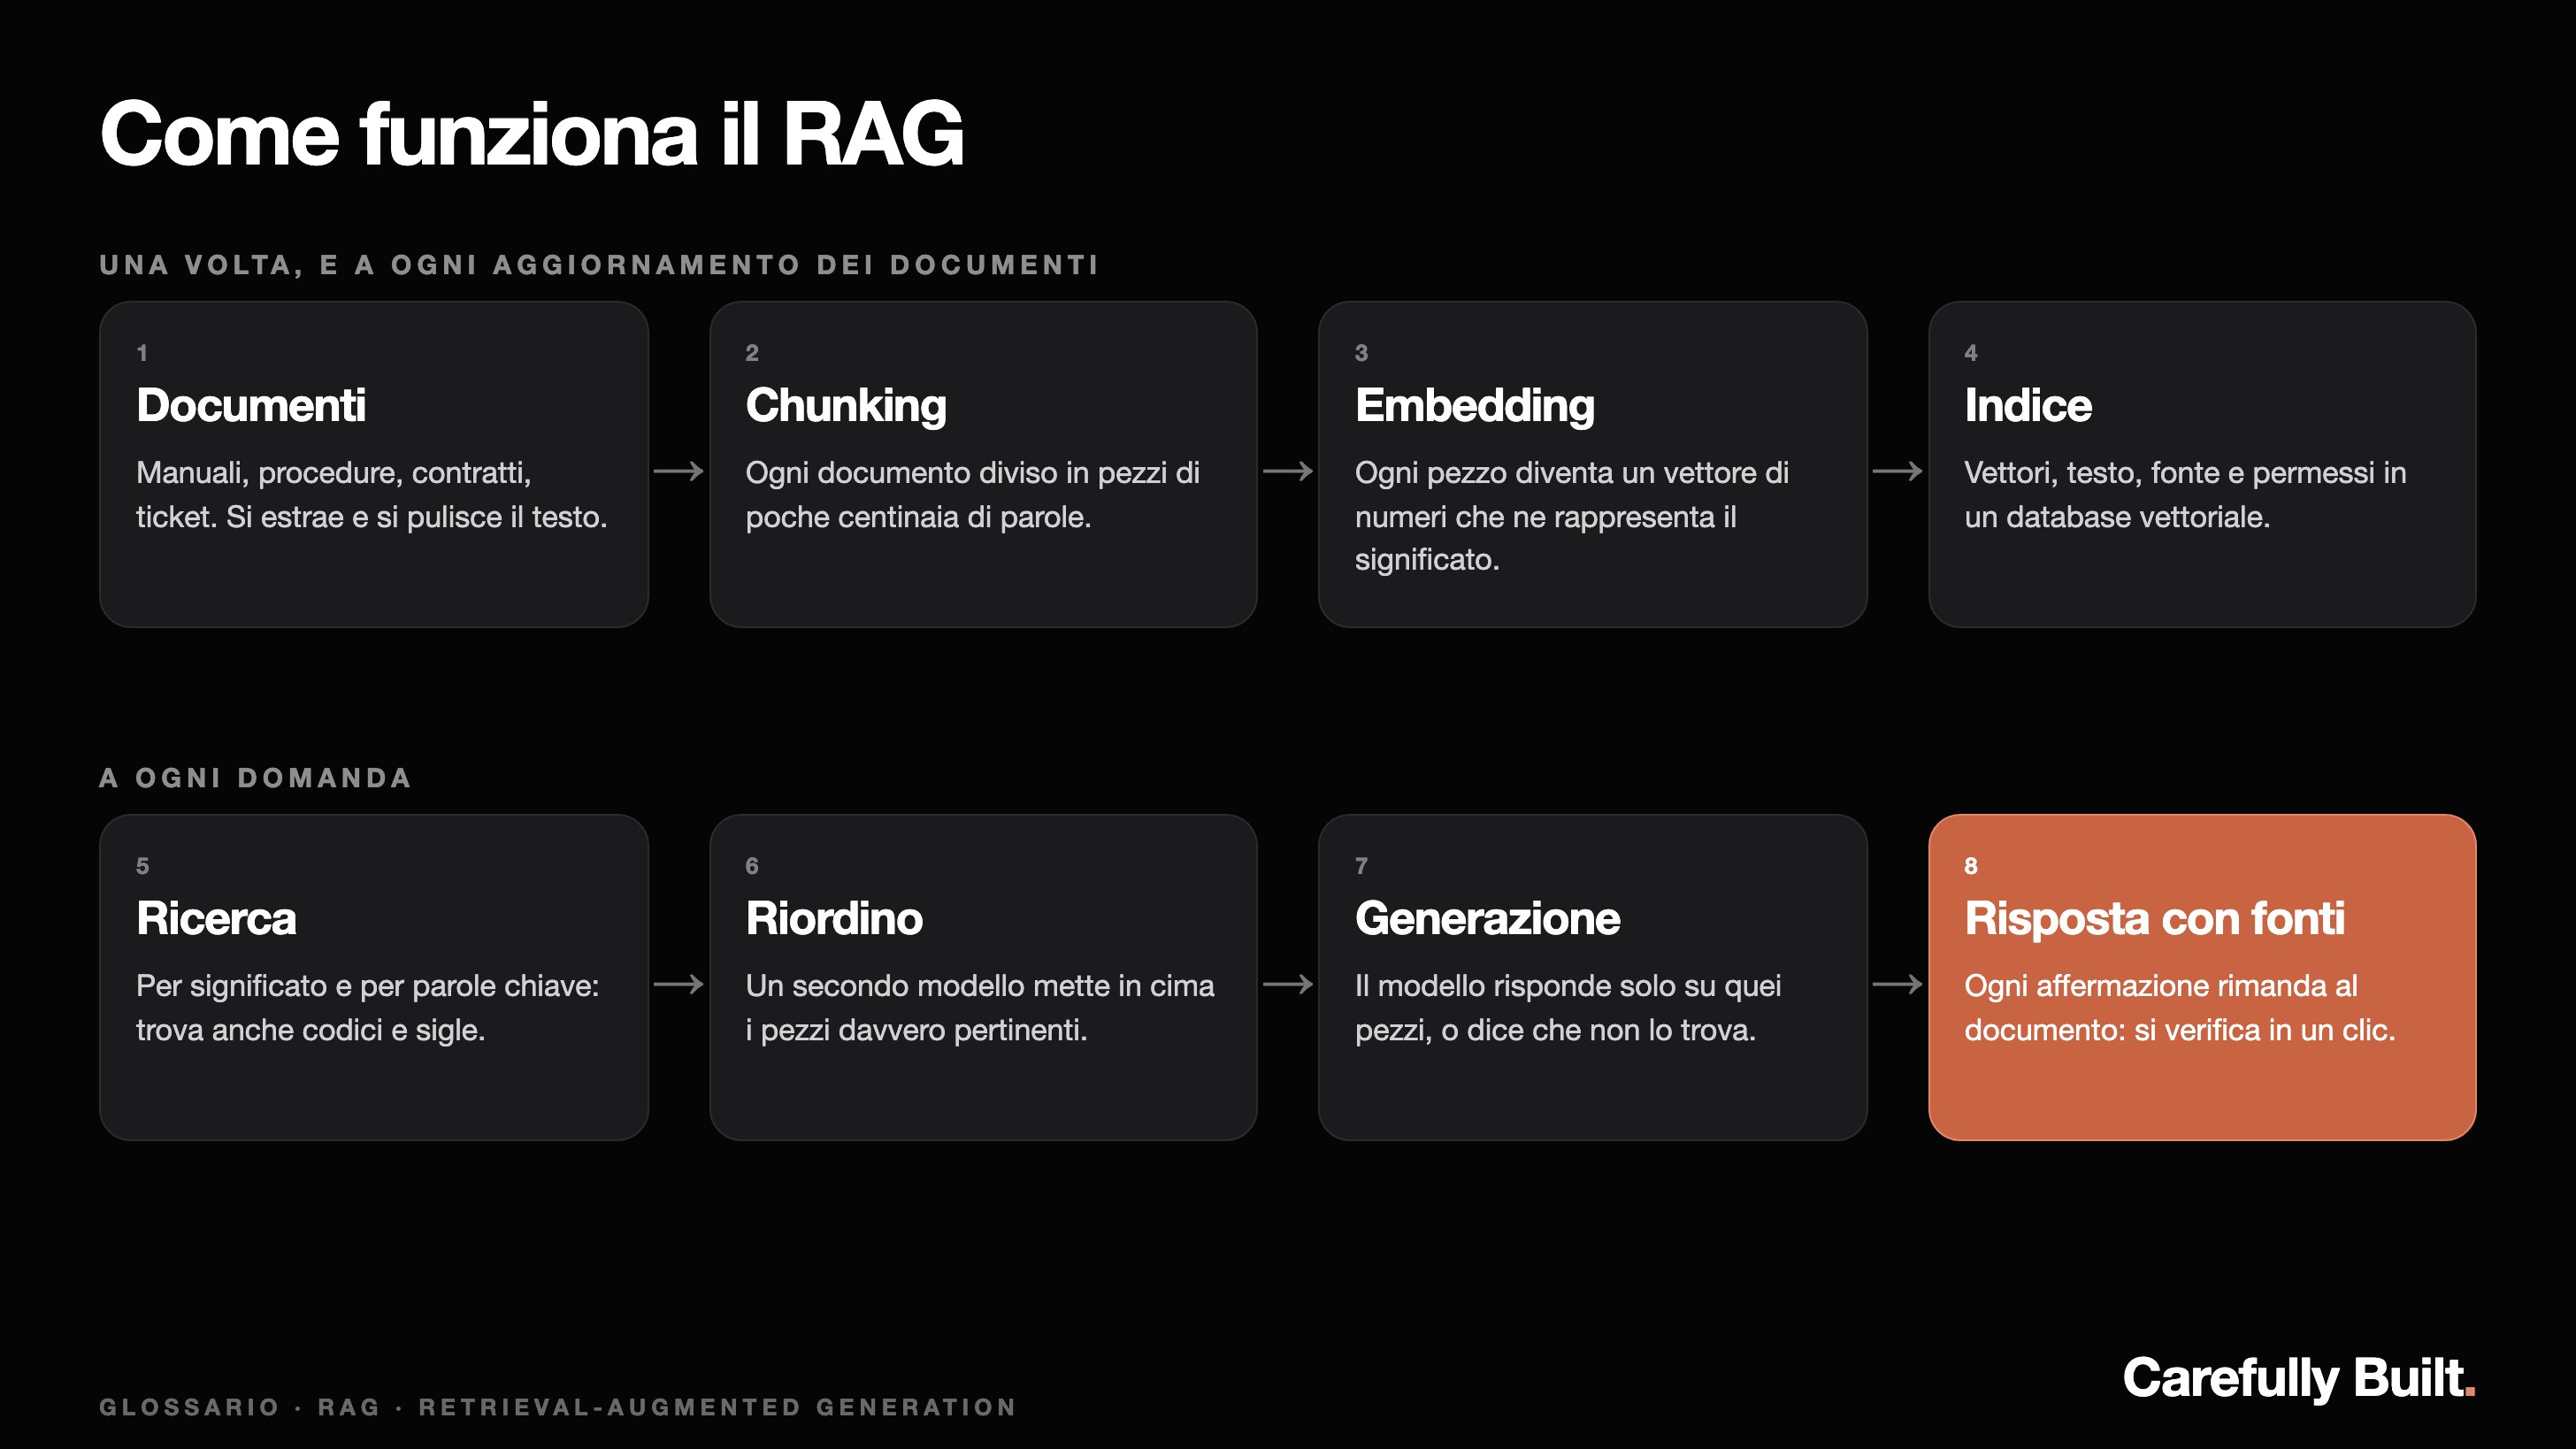
Un sistema RAG ha due fasi: una si fa una volta (e a ogni aggiornamento dei documenti), l’altra a ogni domanda.
Preparazione dell’indice
- Raccolta e pulizia. Si prendono i documenti da dove stanno (cartelle condivise, SharePoint, gestionale, ticket, wiki) e se ne estrae il testo. PDF scansionati, tabelle e intestazioni ripetute vanno sistemati qui: è il passaggio che decide la qualità di tutto il resto.
- Divisione in parti (chunking). Ogni documento viene diviso in pezzi di poche centinaia di parole, possibilmente rispettando paragrafi e sezioni. Pezzi troppo grandi annacquano il significato; troppo piccoli perdono il contesto.
- Embedding. Ogni pezzo viene trasformato da un modello apposito in un vettore, una lista di numeri (per esempio 1.536) che ne rappresenta il significato. Testi che parlano della stessa cosa hanno vettori vicini, anche se usano parole diverse.
- Indice. I vettori finiscono in un database vettoriale (pgvector su PostgreSQL, Qdrant, Pinecone, Weaviate e altri), insieme al testo, alla fonte e ai permessi di ogni pezzo.
A ogni domanda
- Ricerca. Anche la domanda diventa un vettore, e si cercano i pezzi più vicini. Conviene affiancare una ricerca per parole chiave (l’algoritmo BM25), che trova ciò che la ricerca per significato perde: codici articolo, sigle, nomi propri.
- Riordino (reranking). Un secondo modello rilegge i candidati e mette in cima quelli davvero pertinenti.
- Generazione. Domanda e pezzi selezionati vanno al modello linguistico, con l’istruzione di rispondere solo su quella base e di dire “non lo trovo” se l’informazione manca.
- Citazione. La risposta indica documento e punto da cui viene, così chi legge può verificare in un clic.
Quanto contano i passi 5 e 6 lo ha misurato Anthropic in uno studio pubblicato a settembre 2024. Partendo da una ricerca solo per significato che falliva nel 5,7% dei casi, aggiungere a ogni pezzo una breve spiegazione del suo contesto (di quale documento fa parte, di cosa parla la sezione) ha ridotto i fallimenti del 35%; con la ricerca per parole chiave del 49%; con il riordino del 67%, fino all’1,9%.
Un esempio con i numeri
Esempio ipotetico. Un costruttore di macchine ha 2.000 manuali tecnici di 10 pagine ciascuno, in media: 20.000 pagine. I tecnici dell’assistenza fanno circa 3.000 domande al mese, del tipo “come si resetta l’allarme E34 sul modello X dopo la sostituzione del sensore?”.
Indicizzare tutto. Con la stima di OpenAI di circa 800 token per pagina, sono 20.000 × 800 = 16 milioni di token. Con un modello di embedding come text-embedding-3-small (0,02 $ per milione di token) la spesa è 16 × 0,02 = 0,32 $. Rifarlo ogni volta che i manuali cambiano costa praticamente nulla.
Una risposta. Il sistema recupera 20 pezzi da circa 400 token, cioè 8.000 token, più 1.000 tra istruzioni e domanda: 9.000 token in ingresso. Con Claude Sonnet 5.5 (2 $ per milione in ingresso, 10 $ in uscita, listino di novembre 2026):
- ingresso: 9.000 × 2 ÷ 1.000.000 = 0,018 $
- uscita, una risposta di 500 token: 500 × 10 ÷ 1.000.000 = 0,005 $
- totale: circa 0,023 $ a domanda, cioè circa 69 $ al mese per 3.000 domande.
Perché non mettere tutto nel prompt? Perché 16 milioni di token sono 16 volte la finestra di contesto più grande dei modelli Claude attuali, che arriva a 1 milione. E anche se ci stessero, pagare 16 milioni di token a ogni domanda sarebbe assurdo. Il RAG legge ogni volta solo lo 0,06% della base (9.000 token su 16 milioni).
I numeri dicono una cosa importante: in un progetto RAG il costo dei modelli è quasi irrilevante. Quello che costa, e che fa la differenza tra un sistema che risponde bene e uno che risponde a caso, è il lavoro sui documenti, sulla ricerca, sui permessi e sulla valutazione.
RAG, fine-tuning o prompt lungo
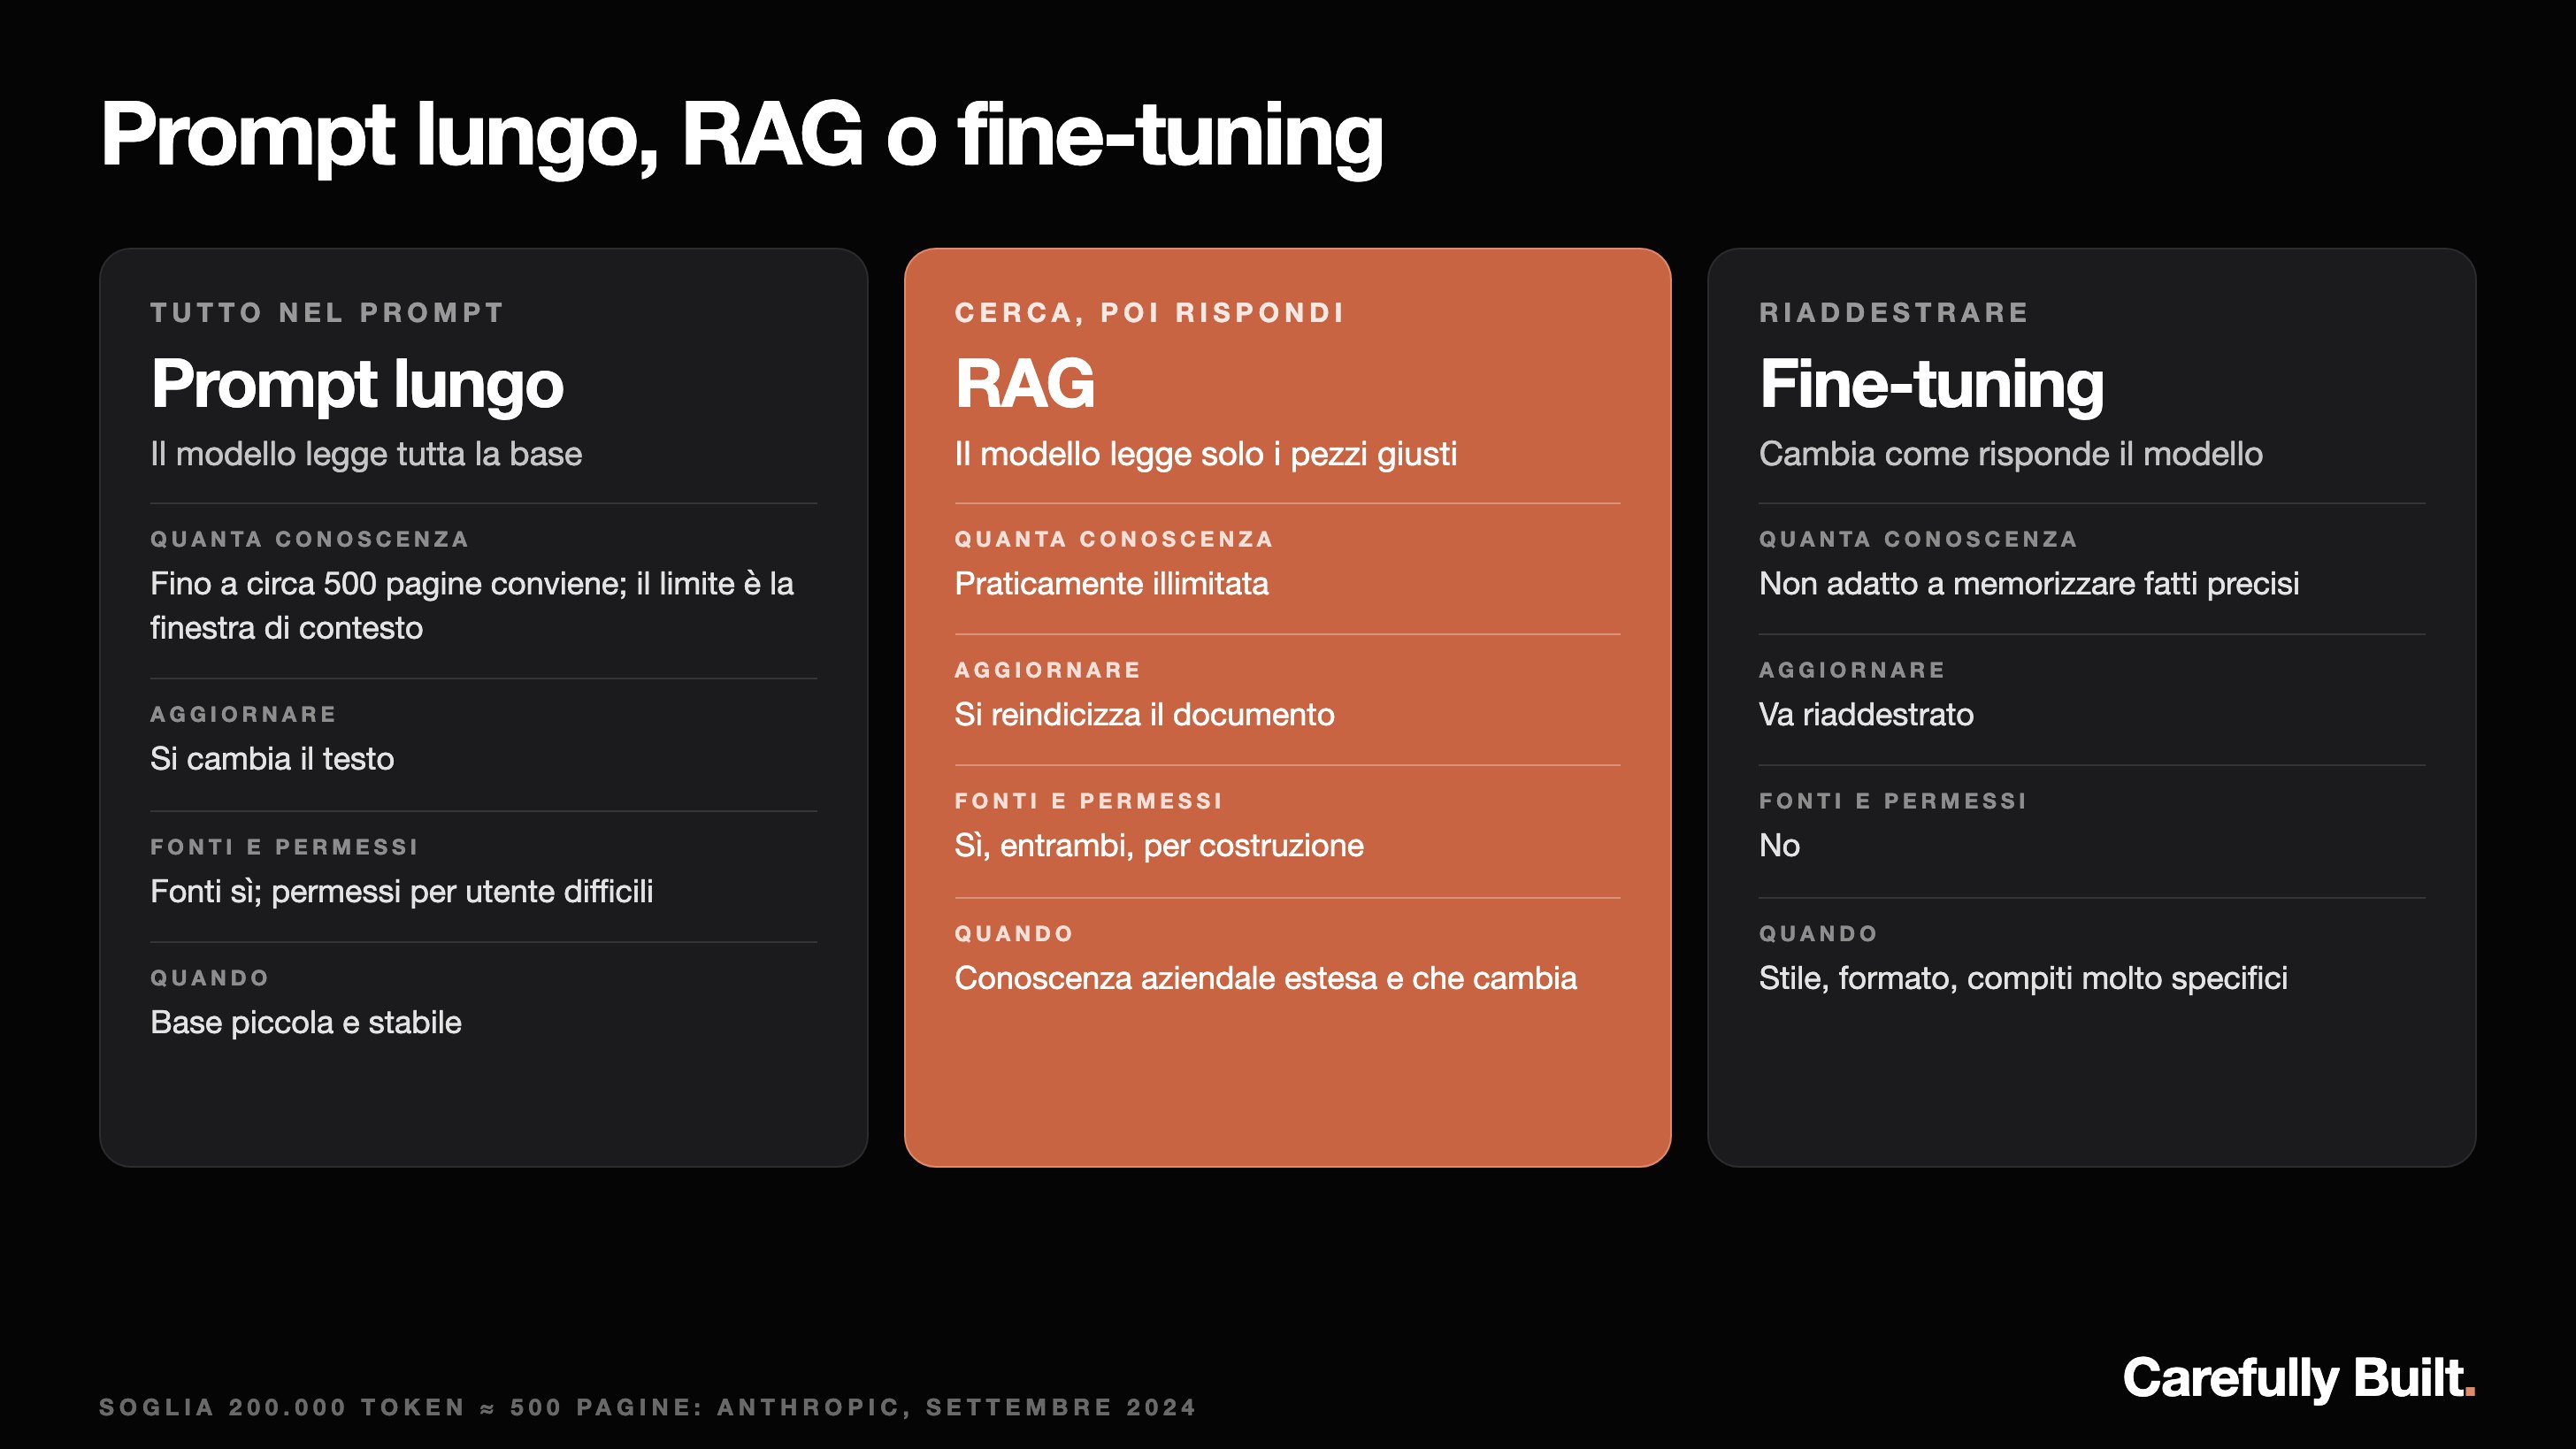
Le tre strade si confondono spesso, ma risolvono problemi diversi:
| Prompt lungo | RAG | Fine-tuning | |
|---|---|---|---|
| Cosa cambia | Cosa legge il modello a ogni domanda | Cosa legge il modello, scelto domanda per domanda | Il comportamento del modello |
| Quanta conoscenza | Fino alla finestra di contesto (oggi fino a 1 milione di token) | Praticamente illimitata | Non adatto a memorizzare fatti precisi |
| Aggiornare i dati | Si cambia il testo | Si reindicizza il documento | Va riaddestrato |
| Fonti citate | Sì, se richiesto | Sì, per costruzione | No |
| Permessi per utente | Difficile | Sì, filtrando la ricerca | No |
| Quando sceglierlo | Base piccola e stabile | Conoscenza aziendale estesa e che cambia | Stile, formato, compiti molto specifici |
Una regola utile viene da Anthropic: se la base di conoscenza sta sotto i 200.000 token, circa 500 pagine, si può includerla tutta nel prompt, usando la cache dei prompt per ridurre costi e tempi. Ma più testo non è sempre meglio: la documentazione di Claude ricorda che, al crescere dei token, l’accuratezza nel ritrovare le informazioni peggiora. Sopra qualche centinaio di pagine, o con documenti riservati a gruppi diversi di persone, il RAG è la scelta giusta.
Il fine-tuning, invece, insegna al modello come rispondere, non cosa sapere. Si usa raramente per la conoscenza aziendale, e quasi mai come prima scelta.
Come si valuta un sistema RAG
Un RAG che “sembra funzionare” in una demo può sbagliare una risposta su cinque in produzione. Per saperlo bisogna misurarlo:
- Si prepara un set di prova: 50–100 domande vere, raccolte da chi lavora, con la risposta giusta e il documento che la contiene.
- Si misura la ricerca: il pezzo giusto è tra quelli recuperati? (Context recall e context precision, nella terminologia della libreria Ragas.)
- Si misura la risposta: dice solo cose presenti nelle fonti (faithfulness)? Risponde davvero alla domanda (response relevancy)?
- Si ripete a ogni modifica di chunking, modello o istruzioni, e si confrontano i numeri.
Con un set di prova, ogni scelta tecnica diventa una scelta misurata: si vede se un riordino in più vale il suo costo, o se il problema è un manuale scansionato male.
I limiti del RAG
- Se il documento è sbagliato, la risposta è sbagliata. Il RAG non corregge i contenuti: li rende consultabili.
- Le domande che richiedono di leggere tutto (“quanti contratti scadono quest’anno?”) non sono il suo forte. Servono dati strutturati, una query sul database, non una ricerca nel testo.
- Tabelle, disegni tecnici e scansioni vanno preparati con cura, o diventano rumore.
- Allucinazioni ridotte, non azzerate. Il modello può ancora fraintendere un passaggio. Le citazioni servono proprio a controllare.
Quando serve a una PMI
I segnali che un RAG può far risparmiare tempo:
- l’assistenza tecnica cerca le procedure in centinaia di manuali, o chiede sempre alle stesse due persone esperte;
- l’ufficio commerciale risponde a domande su condizioni, certificazioni e schede prodotto sparse in cartelle diverse;
- procedure interne, sicurezza e qualità (ISO, HACCP, manuali operativi) sono documentate ma nessuno le trova quando servono;
- i ticket chiusi contengono anni di soluzioni che nessuno rilegge.
Conviene partire in piccolo, con la logica di un MVP: un reparto, un insieme di documenti che fanno fede, un set di prova. Se le risposte reggono, si allarga.
Il RAG è spesso il motore dentro un chatbot aziendale o un agente AI: il chatbot è l’interfaccia, il RAG è il modo in cui trova le risposte giuste, l’agente è ciò che poi agisce (apre un ticket, prepara un’offerta). Per collegarlo a gestionale e CRM si usano API o il protocollo MCP.
Una spiegazione in sei minuti, chiara anche per chi non è tecnico (in inglese):
Progettiamo pipeline RAG sui documenti delle aziende, con permessi, citazioni e un set di prova per misurarne la qualità, e le mettiamo dentro assistenti e chatbot o agenti AI. Se volete capire se i vostri documenti si prestano, scriveteci: partiamo da un campione di manuali e da dieci domande vere.